Schiller war eine KI
Friedrich Schiller hat offenbar geschummelt. Und zwar ziemlich dreist. Ich habe einen Ausschnitt aus „Das Lied von der Glocke“ in einen KI Detektor kopiert.
Das Ergebnis:
100 Prozent KI Inhalt.
Sehr schön. Schiller starb 1805. ChatGPT kam etwas später.
Ein kleiner Test
Mich interessiert schon länger, wie zuverlässig diese ganzen Dienste eigentlich sind, die versprechen, KI Texte zu erkennen.
Also dachte ich mir: Warum soll ich einen Text testen, bei dem ich selbst nicht sicher wissen kann, wie er entstanden ist? Nehmen wir doch einen, bei dem die Sache einigermaßen geklärt sein dürfte. Schillers Glocke erschien 1799. Ich kopierte also einige Verse hinein und bekam dieses Ergebnis:
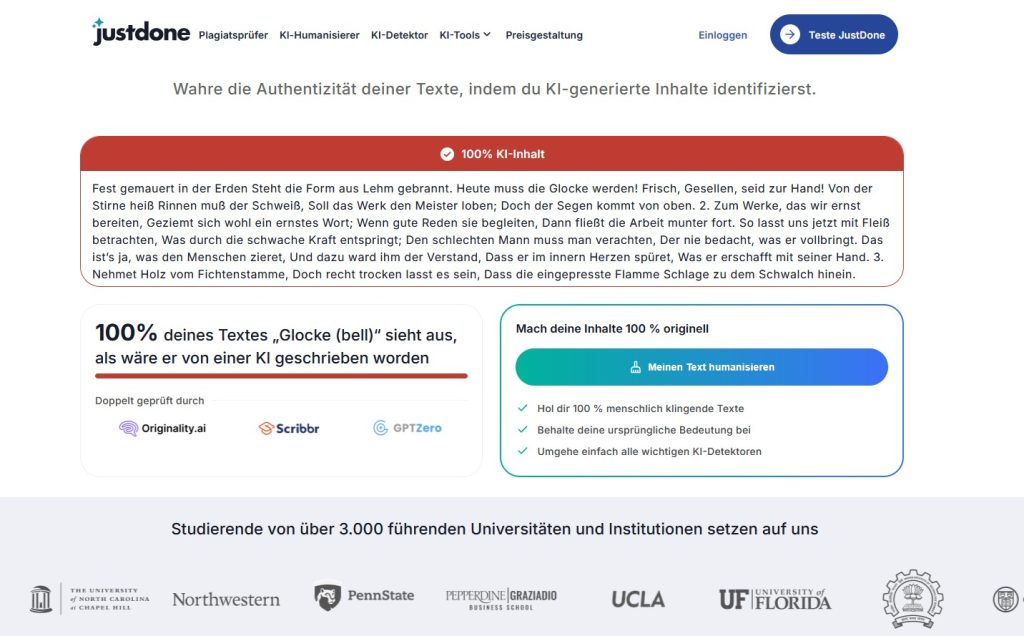
„100 % deines Textes sieht aus, als wäre er von einer KI geschrieben worden.“
Gut. Dann wissen wir das jetzt auch.
Besonders hübsch finde ich, was direkt darunter steht:
„Studierende von über 3.000 führenden Universitäten und Institutionen setzen auf uns.“
Das macht die Sache irgendwie nicht besser.
Was erkennt so ein KI Detektor eigentlich?
Das Missverständnis beginnt schon beim Wort „erkennen“.
Es klingt, als würde die Software einen Text untersuchen und darin irgendwelche eindeutigen Spuren einer künstlichen Intelligenz finden. So ungefähr wie ein Kriminaltechniker einen Fingerabdruck. Das funktioniert bei Text aber nicht.
Ein KI Detektor kennt normalerweise nicht die Entstehungsgeschichte des Textes. Er sieht lediglich Wörter, Sätze und sprachliche Muster. Dann versucht er abzuschätzen, wie ähnlich diese Muster Texten sind, die von Sprachmodellen erzeugt wurden.
- Bestimmte Texte sind sehr regelmäßig.
- Bestimmte Wörter folgen mit hoher Wahrscheinlichkeit aufeinander.
- Sätze besitzen ähnliche Strukturen.
- Der Stil ist vielleicht ungewöhnlich vorhersehbar.
All das kann für einen Detektor verdächtig aussehen. Dummerweise können Menschen genauso schreiben. Schiller offenbar sogar besonders verdächtig.
Der Detektor misst etwas anderes, als wir glauben
Das ist für mich der wichtigste Punkt.
Wenn irgendwo steht:
„98 Prozent KI“
liest man automatisch:
„Dieser Text wurde mit einer Wahrscheinlichkeit von 98 Prozent von einer KI geschrieben.“
Das muss überhaupt nicht gemeint sein. Die Zahl kann lediglich ausdrücken, wie stark der Text innerhalb des Klassifikationsmodells in die Kategorie „KI“ fällt. Das klingt nach einem kleinen Unterschied. Ist aber ein ziemlich großer.
Man stelle sich ein Programm vor, das ausschließlich zwischen Katzen und Hunden unterscheiden kann.
Dann zeigt man ihm einen Fuchs.
Das Programm antwortet:
„99 Prozent Hund.“
Der Fuchs wird dadurch nicht zum Hund. Das Programm hat lediglich innerhalb seiner begrenzten Welt entschieden, dass der Fuchs eher nach Hund als nach Katze aussieht.
Bei einem KI Detektor kann etwas Ähnliches passieren.
Er bekommt Schiller. Schiller schreibt nicht wie die Texte, die das System als typische menschliche Texte kennengelernt hat.
Also:
KI. 100 Prozent. Problem gelöst.
Warum sucht das Ding nicht einfach nach Schiller?
Das war mein nächster Gedanke.
Bevor ich irgendwelche komplizierten statistischen Berechnungen anstelle, könnte ich doch zunächst prüfen:
Gibt es diesen Text schon?
Bei der Glocke wäre das keine besonders anspruchsvolle Recherche. Ein paar charakteristische Wörter reichen und man landet ziemlich schnell bei Friedrich Schiller.
Damit wäre immerhin eine Sache geklärt:
Der Inhalt wurde ganz offensichtlich nicht ursprünglich von ChatGPT geschrieben.
Das bedeutet allerdings noch nicht, dass man die technische Herkunft des Textes kennt.
Ich könnte die Glocke aus einem Buch abgeschrieben haben. Ich könnte sie von einer Webseite kopiert haben. Oder ich könnte ChatGPT gebeten haben:
„Gib mir ein paar Verse aus Schillers Glocke.“
Am Ende steht jedes Mal derselbe Text vor dem Detektor.
Aus diesen Buchstaben allein lässt sich nicht mehr erkennen, welchen Weg sie genommen haben.
Aber genau deshalb wäre eine vernünftige Antwort eben nicht:
„100 Prozent KI.“
Sondern eher:
„Dieser Text entspricht einem bekannten Werk von Friedrich Schiller. Ob diese konkrete Kopie von Hand eingegeben, kopiert oder durch ein Sprachmodell ausgegeben wurde, lässt sich nicht feststellen.“
Ist natürlich weniger spektakulär.
Dann habe ich Matisse getestet
Bei Bildern müsste das doch besser funktionieren.
Schließlich kann eine Software dort viel mehr untersuchen.
- Pixel.
- Rauschen.
- Texturen.
- Farbverläufe.
- Bestimmte Muster, die bei Bildgeneratoren entstehen können.
Also nahm ich ein Werk von Henri Matisse und gab es einem Bilddetektor.
Das Ergebnis:
21 Prozent real.
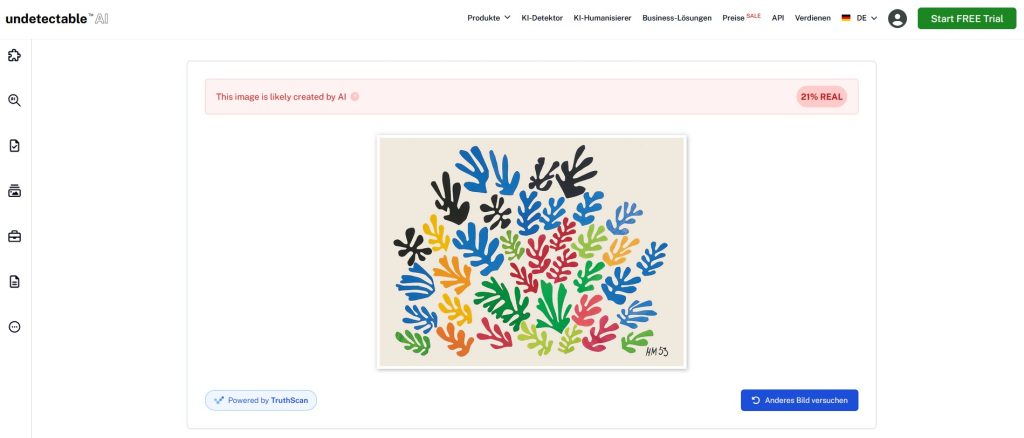
Mit anderen Worten:
Das Bild sei wahrscheinlich von einer KI erzeugt worden.
Auch Matisse war seiner Zeit offenbar weit voraus.
Bei Bildern ist die Sache tatsächlich etwas komplizierter
Ein Bilddetektor hat grundsätzlich mehr Material zur Verfügung als ein Textdetektor. Generierte Bilder können bestimmte statistische Spuren besitzen, die bei Fotografien oder eingescannten Bildern anders aussehen.
Das Problem:
Auch diese Spuren sind nicht eindeutig.
- Ein altes Kunstwerk kann fotografiert oder eingescannt werden.
- Danach wird es verkleinert.
- Komprimiert.
- Auf einer Webseite angezeigt.
- Vielleicht macht jemand einen Screenshot davon.
- Dann wird es erneut gespeichert.
Der Detektor untersucht am Ende also nicht den echten Matisse an der Wand. Er untersucht eine digitale Datei, die möglicherweise schon einige technische Stationen hinter sich hat.
Und offenbar kann dabei etwas herauskommen, das für die Software verdächtig künstlich aussieht.
Eigentlich müsste man zuerst nach der Herkunft suchen
Gerade bei bekannten Texten und Bildern erscheint mir deshalb eine andere Reihenfolge sinnvoller.
Zuerst müsste man prüfen:
- Existiert dieses Werk bereits?
- Woher stammt es?
- Seit wann ist es dokumentiert?
- Gibt es übereinstimmende Quellen?
- Bei Bildern könnte man eine Bildähnlichkeitssuche verwenden.
- Bei Texten eine normale Textsuche.
Erst wenn dabei nichts herauskommt, könnte man sich mit statistischen Hinweisen beschäftigen.
Auch das würde keinen perfekten KI Detektor ergeben.
Aber man würde wenigstens vermeiden, Friedrich Schiller mit hundertprozentiger Sicherheit bei der Benutzung einer Technologie zu erwischen, die ungefähr zwei Jahrhunderte nach seinem Tod entwickelt wurde.
Und was bedeutet dann „100 Prozent KI“?
Für mich inzwischen vor allem:
Nicht besonders viel.
Zumindest nicht ohne zusätzliche Informationen.
Ich würde wissen wollen:
- Wie hoch ist die Fehlerquote?
- Welche Texte wurden zum Testen verwendet?
- Funktioniert das System auf Deutsch genauso gut wie auf Englisch?
- Wie verhält es sich bei Literatur?
- Bei wissenschaftlichen Texten?
- Bei Menschen, die sehr formell schreiben?
- Was passiert mit älteren Texten?
Und vor allem:
Was genau bedeutet diese Prozentzahl überhaupt?
Darüber erfährt man auf vielen dieser Seiten erstaunlich wenig. Die große rote Anzeige bekommt man dagegen sofort.
100 Prozent.
Das sieht schön eindeutig aus.
Das kann ziemlich unangenehm werden
Solange ich aus Spaß Schiller in so einen Detektor werfe, ist das alles recht lustig.
Bei einer Hausarbeit sieht die Sache anders aus.
Ein Student schreibt einen Text selbst.
Ein Detektor schlägt an. Der Dozent sieht:
„94 Prozent KI.“
Und plötzlich muss jemand beweisen, dass er seinen eigenen Text tatsächlich selbst geschrieben hat. Genau dort wird aus einem lustigen Fehlalarm ein ernsthaftes Problem.
Denn der Detektor hat keinen Autor entdeckt. Er hat ein statistisches Muster gefunden.
Vielleicht lag er richtig. Vielleicht auch nicht.
Schiller kann davon inzwischen ein Lied singen.
Genauer gesagt:
eine Glocke.
Und die 3.000 Universitäten?
Der Satz auf der Webseite ist übrigens geschickt formuliert.
Dort steht sinngemäß, Studierende von mehr als 3.000 Universitäten und Institutionen würden den Dienst nutzen.
Das bedeutet nicht, dass diese Universitäten den Dienst geprüft haben. Es bedeutet auch nicht, dass sie ihn empfehlen. Und schon gar nicht, dass ein Ergebnis wie „100 Prozent KI“ wissenschaftlich als Beweis anerkannt wäre.
Es bedeutet zunächst nur das, was dort steht:
Studierende benutzen ihn.
Studierende benutzen allerdings auch Wikipedia, ChatGPT und vermutlich gelegentlich Tinder.
Daraus folgt noch keine institutionelle Empfehlung.
Kann man KI also überhaupt sicher erkennen?
Bei einem beliebigen Text:
Nein.
Zumindest nicht mit hundertprozentiger Sicherheit aus dem Text allein.
Bei Bildern gibt es mehr technische Spuren. Auch dort gibt es aber keine universelle Methode, die jedes beliebige Bild zuverlässig als menschlich oder künstlich identifizieren kann.
Anders sieht es aus, wenn ein Generator absichtlich ein Wasserzeichen hinterlässt oder eine Datei überprüfbare Informationen über ihre Herkunft enthält.
Dann besitzt man tatsächlich zusätzliche Informationen. Ein normaler KI Detektor hat diese meistens nicht. Er schaut sich das Ergebnis an und schätzt. Manchmal ziemlich gut. Manchmal weniger gut.
Und manchmal erklärt er Friedrich Schiller zu hundert Prozent zur künstlichen Intelligenz.
Ich denke, Schiller ist damit rehabilitiert. Bei Matisse bin ich ebenfalls optimistisch.
Bei den Prozentanzeigen wäre ich etwas vorsichtiger.